
到目前為止,我們的 PokeThreads 已是一套有相當程度的分散式系統,元件包含 Load Balancer、Stateless Server、Read Replica、Sharding、Cache、CDN、Message Queue、Search、Counter System,但這些元件都隱含了一個沒有明講的假設,就是它們全部都放在同一個資料中心(Data Center)裡。
Day 9 我們用 CDN 解決了圖片、影片的全球傳遞問題,不管使用者在哪裡,靜態檔案都能就近從 Edge 拿到。但今天要問一個更根本的問題:
如果 Pikachu 人在亞洲,我們的 Server、Database 卻全部蓋在美國,會發生什麼事?
CDN 能解決媒體檔案的延遲,是因為圖片、影片這種靜態內容可以被快取到全球各地的 Edge 節點。但 GET /feed、POST /posts 這種需要即時運算、即時查詢 Database 的動態 Request,沒辦法用同樣的方式處理,它們必須真的打到 Application Server,而 Server 目前只蓋在美國。
假設美國到亞洲的網路來回時間(RTT)是 200ms,Pikachu 每一次打開 Feed、每一次發文、每一次按讚,都要先付出這 200ms 的基本延遲,這還沒算上 Server 實際處理的時間。CDN 處理的是「內容傳遞」,而這裡要處理的是「應用程式本身」的全球化,這是完全不同層次的問題。
最簡單、成本也最低的做法,是把 Day 7 介紹過的 Read Replica 概念,直接搬到地理維度上。
在不同區域各自部署一組 Application Server + Cache + Replica DB,讓使用者的讀取優先在自己所在區域完成,只有寫入才跨區域送回主要區域的 Primary DB。
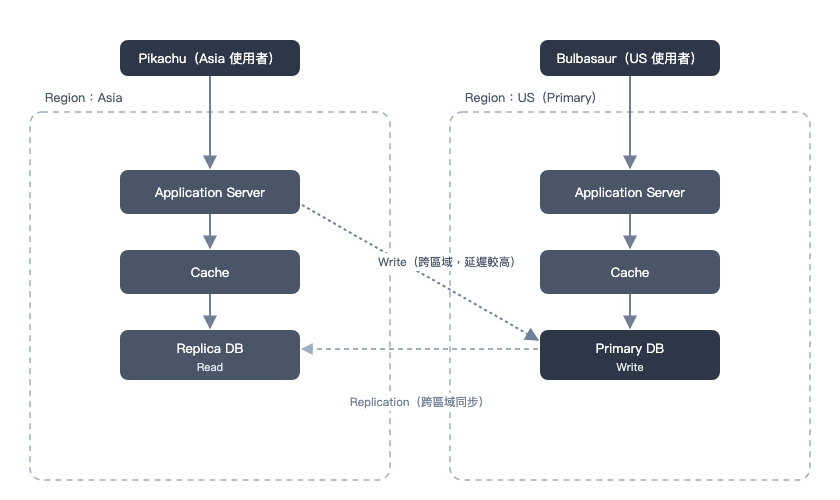
以 Pikachu(亞洲)跟 Bulbasaur(美國)為例:
Pikachu 看 Feed   → 打到 Asia Region 的 Server → 讀 Asia 的 Replica DB(本地,快)
Pikachu 發文      → 打到 Asia Region 的 Server → 寫入 US 的 Primary DB(跨區域,較慢)
Bulbasaur 看 Feed → 打到 US Region 的 Server   → 讀 US 的 Primary DB(本地,快)
這個做法的好處很明顯,多數操作是 Read(回想 Day 7 提過的 Read/Write 流量比例),把佔大多數的 Read 留在使用者附近處理,就能讓大部分 Request 感覺不到跨區域延遲,而寫入雖然還是要跨區域,但頻率低很多所以多半可以接受。
這本質上是 Day 7 Read Replica 架構的地理延伸,差別只在於 Replica 不再是隔壁機櫃的另一台機器,而是隔了半個地球的另一個資料中心,同步延遲(Replication Lag)也從毫秒等級,拉長到可能數十甚至上百毫秒。
如果連寫入也想要在地化處理呢?那就要走向更複雂的 Active-active 架構:多個區域都能接受寫入,不再有單一 Primary。聽起來很吸引人,但這裡會直接碰上 Day 17 討論過的 CAP Theorem,當時也有帶到 Active-active。
跨區域的網路連線,就是「不可靠的網路」最典型的樣子,像是線路品質、繞送路徑甚至海底電纜的物理距離,都會讓 Partition(分區)發生的機率遠高於同一個資料中心內部。
假設亞洲跟美國兩個區域,都同時接受某個使用者資料的寫入,一旦兩地之間網路出現分區就要做出取捨:
而且這個取捨不再是之前舉例「幾秒鐘的 Replication Lag」,而是實際發生在每一次跨區域同步上的固定成本。
同一個資料中心內部的 Replication 可能是次毫秒等級,跨區域的 Replication 光是物理距離造成的延遲,就可能是幾十到幾百毫秒。這個數量級的差異,讓 Active-active 架構的資料衝突處理變得非常棘手,需要額外的機制(例如 Conflict-free Replicated Data Type、或是針對特定欄位設計合併規則)才能讓多區域同時寫入不會讓資料變得一團亂。
除了效能,還有一個經常被低估的驅動力:法規要求。
有些國家或地區的法律規定,特定類型的使用者資料(例如個資、金融資料)必須實際儲存在該國境內的資料中心,不能傳到境外,這稱為 Data Residency(資料落地)。
這種情況下,多區域架構就不只是「為了效能」的選項,而是「不做就違法」的硬性需求,即使該區域的使用者量不大,也必須在當地建立完整的資料儲存能力。
雖然 Active-active 架構聽起來比較秋條,但它帶來的複雜度是全面性的,例如資料衝突處理、跨區域交易一致性、Failover 邏輯都要重新設計。
對多數公司來說,「區域化 Read Replica + 單一 Primary 寫入」已經能拿到全球化效能改善的大部分好處,成本卻只是 Active-active 的一小部分。
真正需要 Active-active 的場景,通常是寫入頻率極高、且對寫入延遲極度敏感的服務(例如全球性的協作編輯工具),或是前面提到的 Data Residency 強制要求「這個區域的寫入不能離開這個區域」的情況。
判斷要走到哪一步,跟前面每一個元件的引入邏輯一樣:先看清楚問題的規模,再決定要付出多少複雜度。
今天把架構從「單一資料中心」,延伸成「多區域」:
除了效能,Data Residency 這類法規要求,也可能讓多區域架構從「效能優化」變成「不得不做」的硬性條件。
目前已經涵蓋了效能、擴展性與全球化,可一個系統要真正上線,還缺一塊很重要的拼圖,如果有人想要惡意攻擊這個系統呢?這是明天要處理的問題。


 iThome鐵人賽
 看影片追技術